페이징과 세그먼테이션, 그리고 페이지 교체 알고리즘
왜 메모리 관리 기법이 필요한가
다중 프로그래밍 시스템에서는 여러 프로세스를 동시에 주기억장치(Main Memory)에 올려야 한다. 그런데 메모리는 한정되어 있고, 프로세스의 크기는 제각각이기 때문에 어떻게 나눠서 할당할 것인가에 대한 전략이 필요하다. 이 전략에 따라 메모리 관리 기법은 크게 두 갈래로 나뉜다.
- 연속 메모리 관리: 프로그램 전체가 하나의 연속된 공간에 올라가야 함
- 불연속 메모리 관리: 프로그램을 여러 조각으로 나눠서 서로 다른 위치에 흩어서 적재 가능
오늘 글에서는 불연속 메모리 관리의 두 축인 페이징과 세그먼테이션을 정리하고, 가상 메모리 환경에서 필연적으로 따라오는 페이지 교체 알고리즘까지 이어서 다룬다.
1. 연속 메모리 관리
프로그램 전체가 하나의 큰 공간에 통째로 올라가야 하는 방식이다.
| 기법 | 설명 | 발생하는 단편화 |
|---|---|---|
| 고정 분할 | 주기억장치를 미리 정해진 크기의 파티션으로 나눔 | 내부 단편화 |
| 동적 분할 | 프로세스 크기에 맞춰 파티션을 그때그때 생성 | 외부 단편화 |
- 내부 단편화: 파티션 크기 > 프로세스 크기일 때, 남는 공간이 낭비됨
- 외부 단편화: 파티션들이 빠지고 채워지는 과정에서, 합치면 충분하지만 흩어져 있어 못 쓰는 공간이 생김
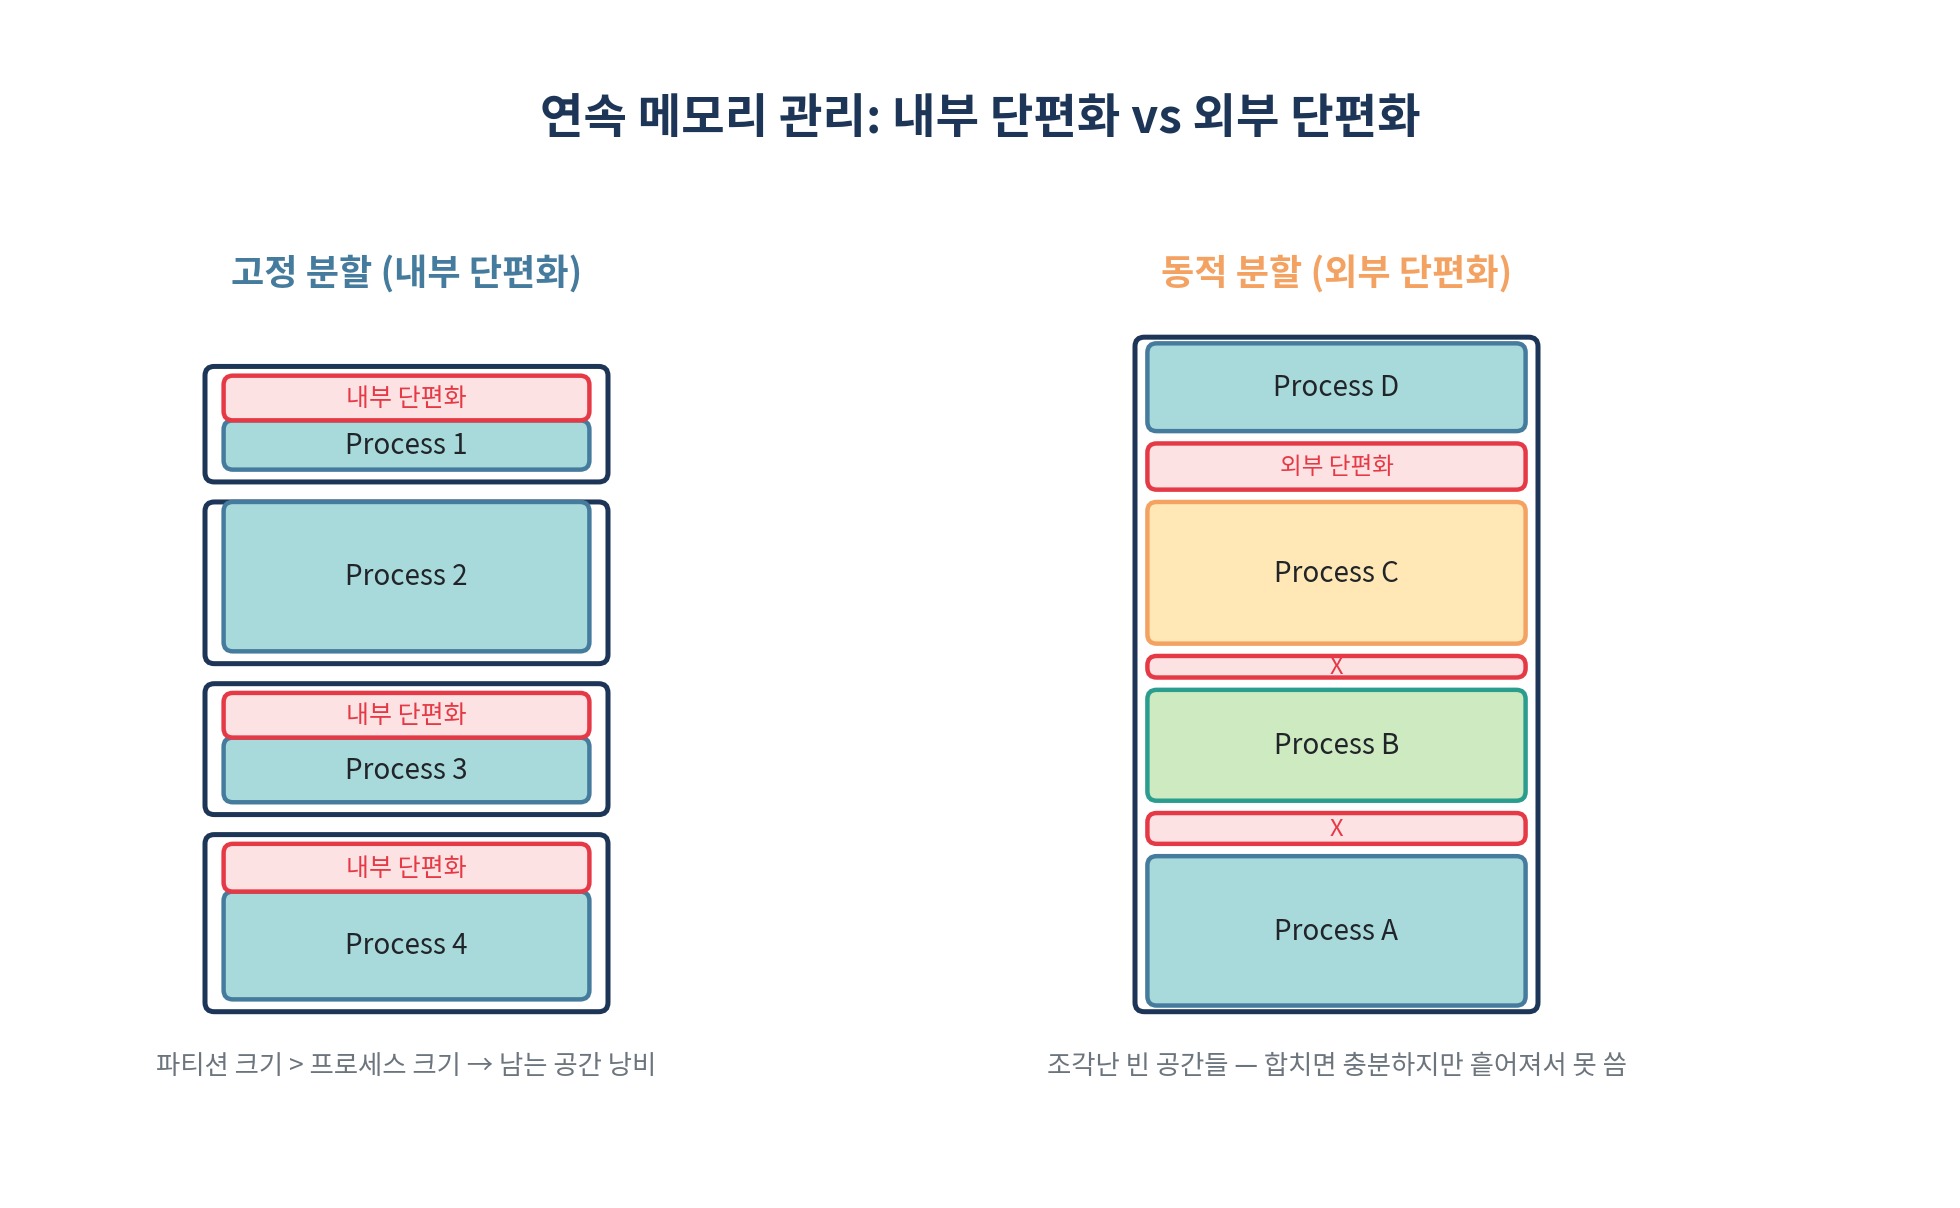
연속 할당은 구조가 단순하지만 단편화 문제 때문에 메모리 활용률이 떨어진다. 이를 해결하기 위해 등장한 것이 불연속 메모리 관리다.
2. 불연속 메모리 관리: 핵심 용어
| 용어 | 의미 |
|---|---|
| 페이지(Page) | 프로세스를 고정 크기로 잘라낸 조각 |
| 프레임(Frame) | 페이지와 같은 크기로 나눈 주기억장치 조각 |
| 세그먼트(Segment) | 의미 단위(코드, 데이터 등)로 나눈 가변 크기 논리적 블록 |
| 단편화 | 메모리 빈 공간 또는 자료가 여러 조각으로 흩어지는 현상 |
여기서 핵심 갈림길이 나온다.
- 고정 크기로 나누면 → 페이징(Paging)
- 가변 크기로 나누면 → 세그먼테이션(Segmentation)
3. 페이징 (Paging)
3.1 단순 페이징
프로세스를 프레임과 동일한 길이의 균등한 페이지로 잘라서 메모리 전체에 흩어 적재하는 방식이다.
- 외부 단편화가 발생하지 않음 (모든 조각이 프레임 크기로 딱 맞기 때문)
- 다만 마지막 페이지가 프레임을 다 채우지 못하면 소량의 내부 단편화는 발생할 수 있음
3.2 페이지 테이블과 주소 변환
페이징의 핵심은 논리 주소 → 물리 주소 변환이다. CPU가 사용하는 논리 주소는 (페이지 번호, 페이지 내 오프셋)으로 구성되고, 이를 실제 메모리 위치로 바꿔주는 것이 페이지 테이블(Page Table)이다.
페이지 테이블의 각 엔트리(PTE)는 보통 다음 정보를 담는다.
- 프레임 번호: 이 페이지가 실제로 적재된 물리 프레임 위치
- Valid/Invalid bit: 해당 페이지가 현재 메모리에 적재되어 있는지 여부
- Dirty bit(Modified bit): 페이지 적재 이후 내용이 수정되었는지 여부 (교체 시 디스크 재기록 필요 여부 판단)
- Reference bit: 최근에 참조되었는지 여부 (교체 알고리즘에서 활용)
- 보호 비트(Protection bit): read-only / read-write 등 접근 권한
페이지 테이블 자체도 메모리에 있기 때문에, 매번 주소 변환마다 메모리를 한 번 더 접근해야 하는 비효율이 생긴다. 이를 줄이기 위해 TLB(Translation Lookaside Buffer)라는 캐시를 MMU(Memory Management Unit) 내부에 두고, 최근 사용한 주소 변환 결과를 저장해 둔다. TLB에서 변환에 성공하면(TLB Hit) 메모리 접근 한 번으로 끝나지만, 실패하면(TLB Miss) 페이지 테이블까지 가야 해서 느려진다.
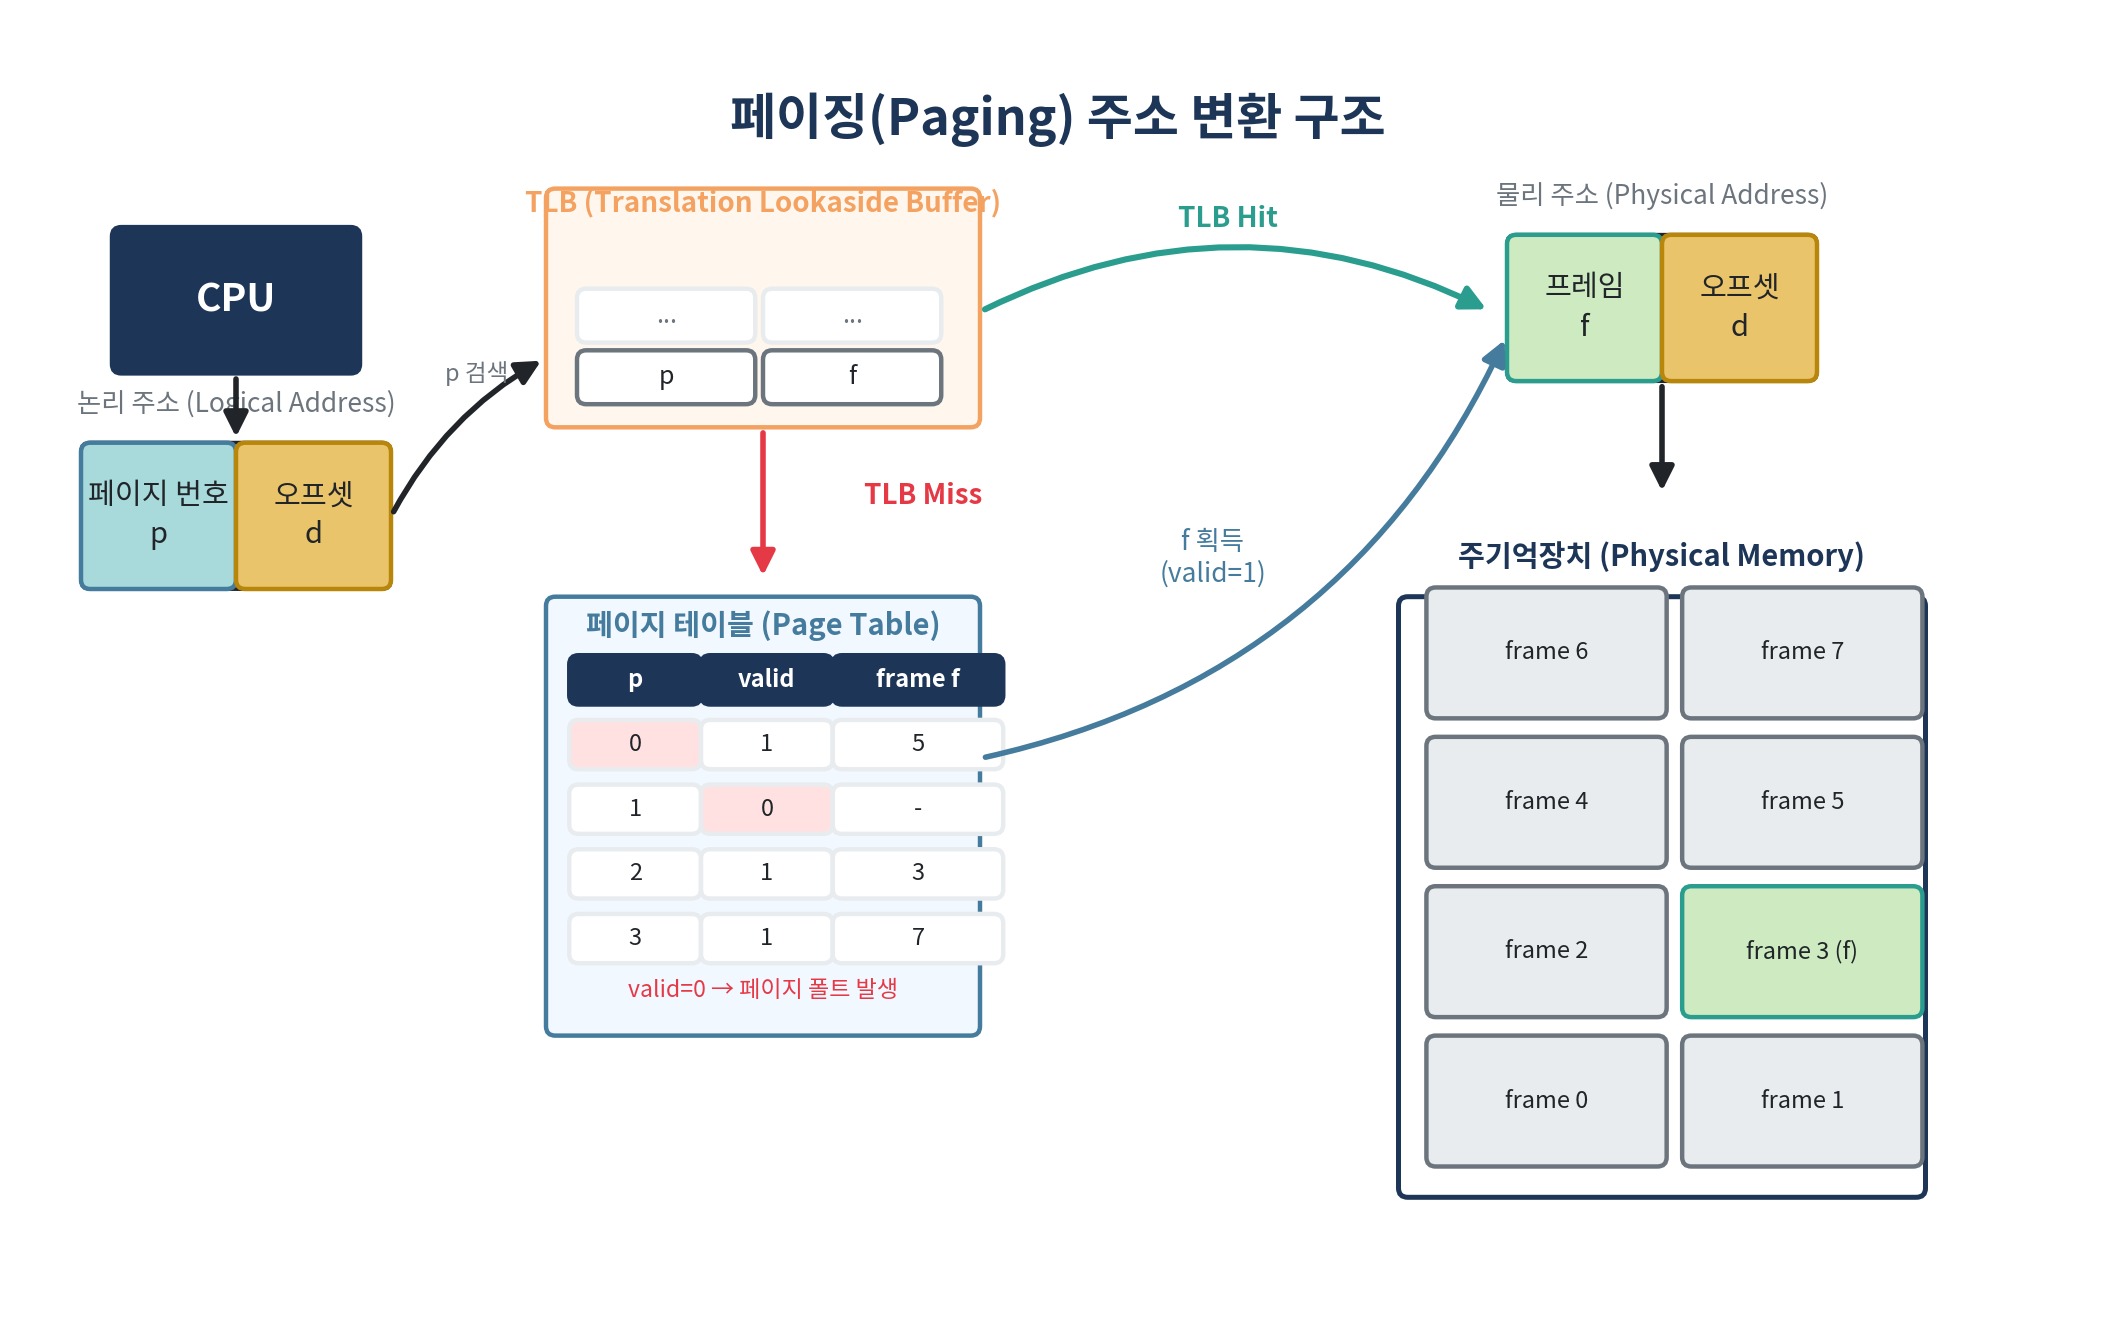
프로세스가 커질수록 페이지 테이블 자체가 거대해지는 문제가 있는데, 이를 보완하기 위해 다단계 페이지 테이블(Multi-level Page Table)이나 역페이지 테이블(Inverted Page Table) 같은 구조도 사용된다. 다단계 페이지 테이블은 페이지 테이블을 계층적으로 쪼개 실제 쓰이는 부분만 메모리에 올려 공간을 절약하고, 역페이지 테이블은 프레임 기준으로 테이블을 구성해 프로세스 수와 무관하게 테이블 크기를 일정하게 유지한다.
3.3 가상 메모리 페이징 (Demand Paging)
단순 페이징은 프로세스의 모든 페이지를 한 번에 메모리에 올려야 하지만, 가상 메모리 페이징은 그렇지 않다.
- 프로세스 페이지 전체를 미리 로드할 필요가 없음
- 실제로 필요한 페이지만 그 시점에 메모리로 올림 (요구 페이징, Demand Paging)
- 외부 단편화가 발생하지 않음
- 다만 어떤 페이지가 메모리에 있는지/없는지 관리하는 복잡도와 오버헤드가 추가됨
CPU가 참조한 페이지가 메모리에 없으면 페이지 폴트(Page Fault)가 발생하고, 대략 다음 순서로 처리된다.
- CPU가 특정 논리 주소 참조 → 페이지 테이블 확인
- Valid bit가 0이면(메모리에 없음) → 페이지 폴트 발생, 트랩(Trap)으로 OS에 제어 넘김
- 디스크(보조기억장치)에서 해당 페이지를 찾아 빈 프레임에 적재
- 빈 프레임이 없다면 페이지 교체 알고리즘으로 내보낼 페이지(victim page)를 선정
- 페이지 테이블 갱신 후, 원래 명령어를 재실행
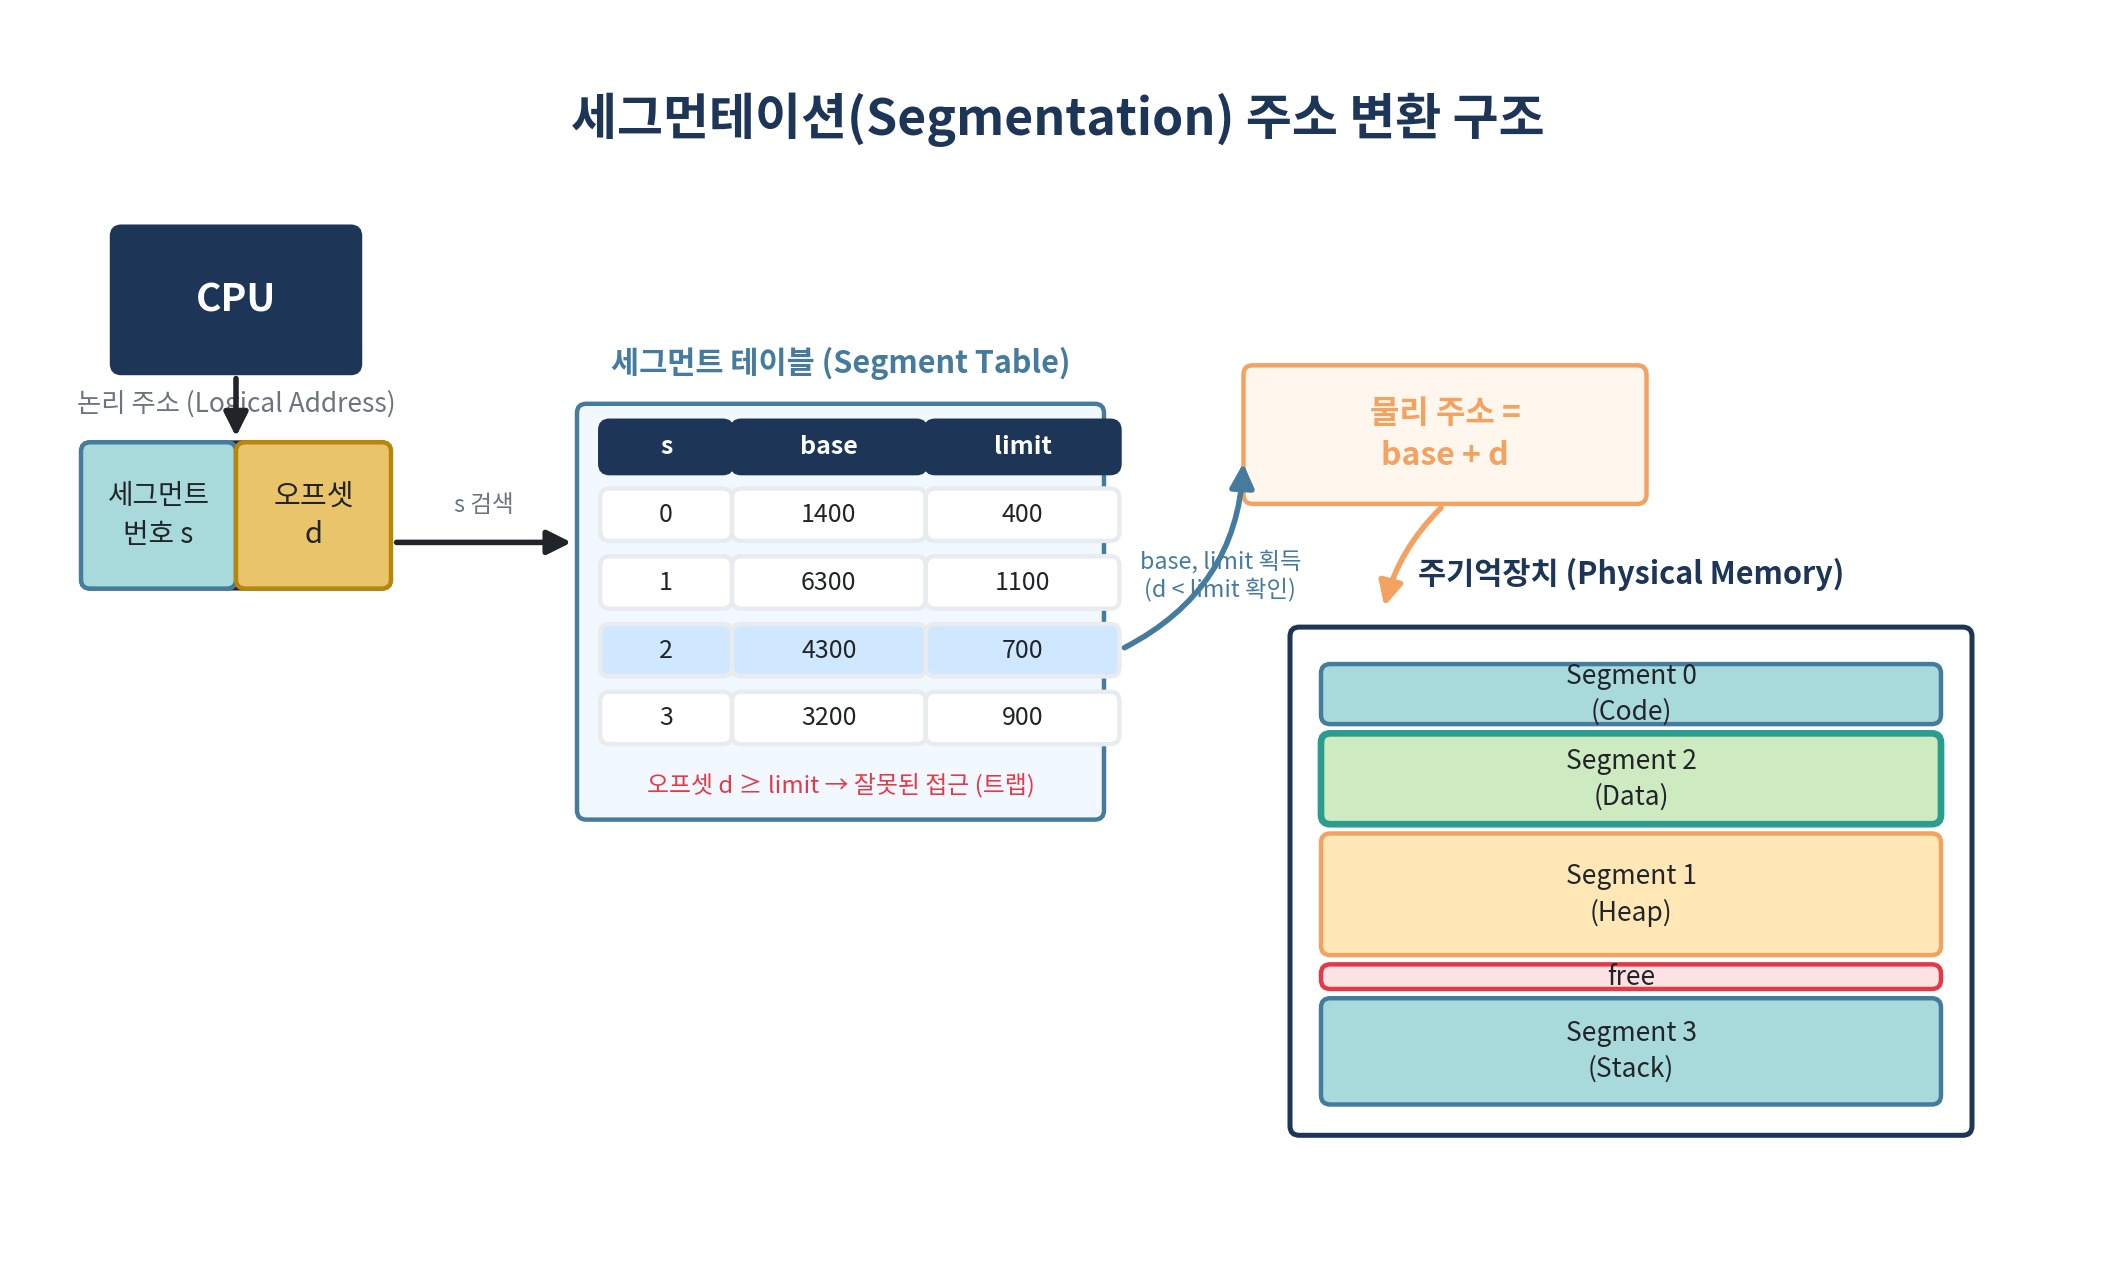
이 5번 과정에서 등장하는 “어떤 페이지를 내보낼 것인가”에 대한 결정 기준이 바로 뒤에서 다룰 페이지 교체 알고리즘이다.
4. 세그먼테이션 (Segmentation)
4.1 단순 세그먼테이션
프로세스를 코드, 데이터, 스택처럼 의미 있는 논리적 단위로 나누는 방식이다. 페이징과 달리 각 조각의 크기가 가변적이다.
- 내부 단편화가 발생하지 않음 (필요한 만큼만 잘라 쓰기 때문)
- 메모리 사용 효율 개선, 동적 분할에 따른 오버헤드 감소
- 다만 세그먼트 크기가 제각각이라 외부 단편화는 발생할 수 있음
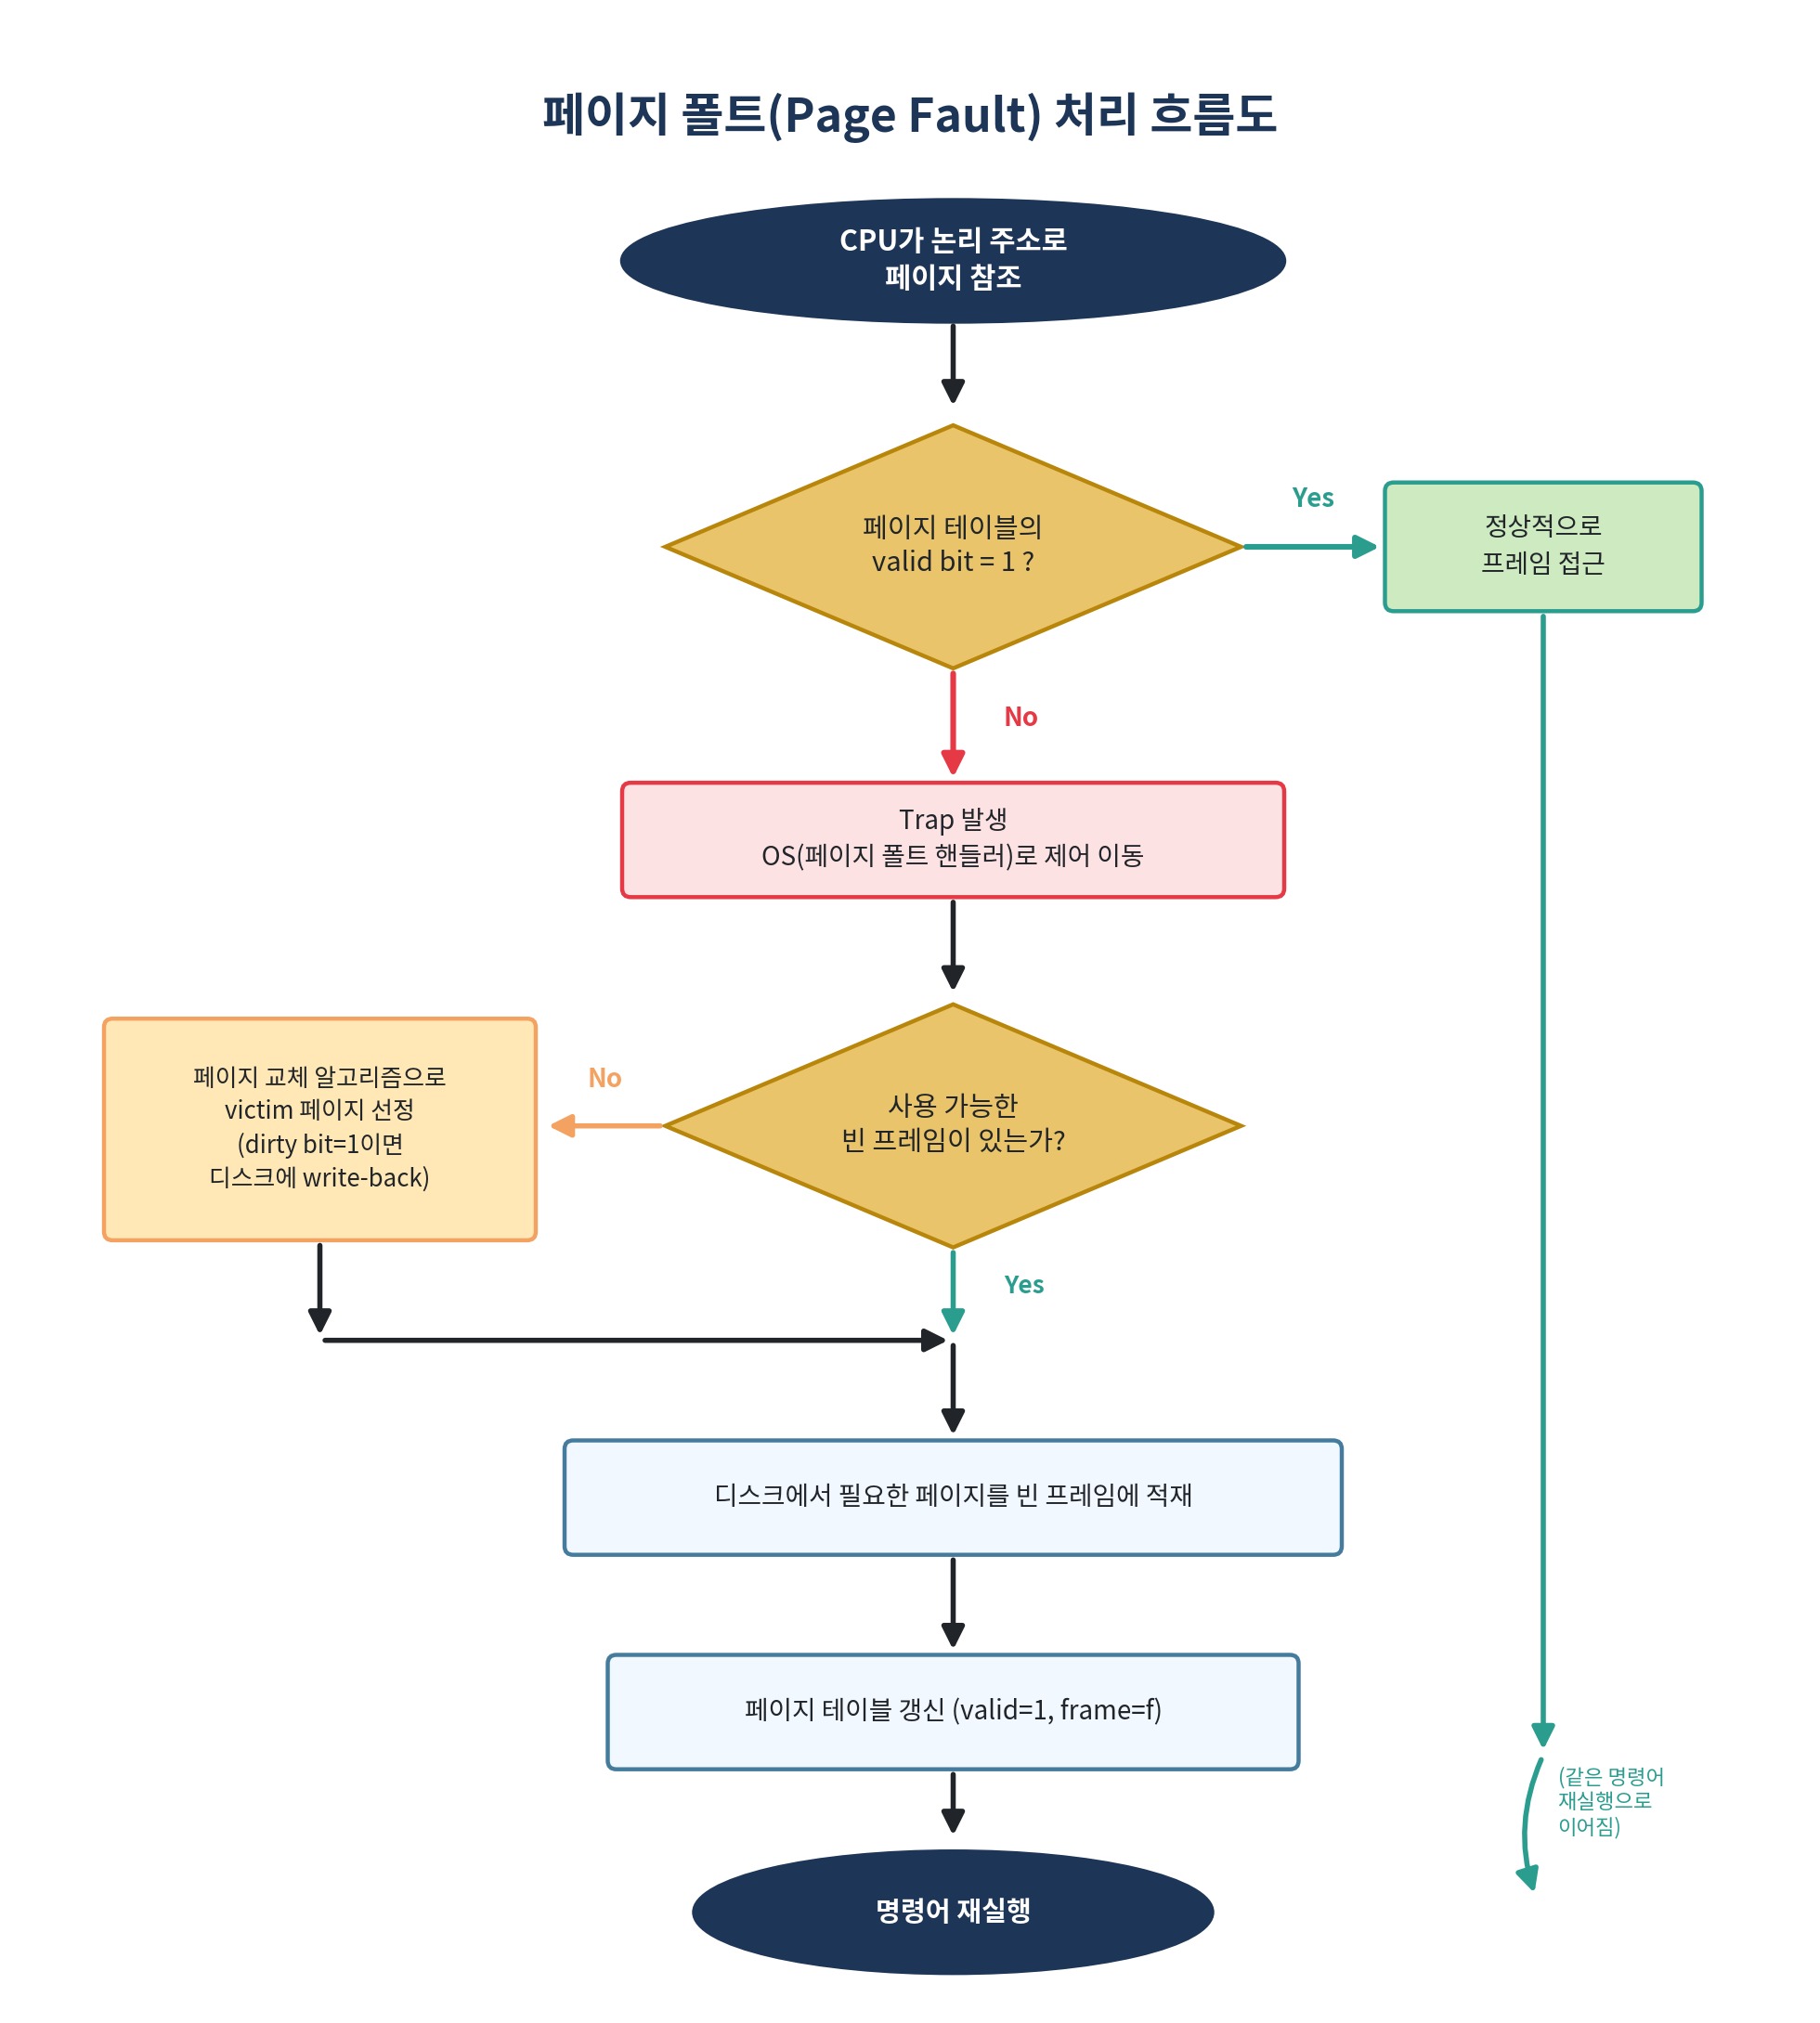
세그먼트 테이블의 엔트리는 페이지 테이블과 달리 base(시작 주소)와 limit(세그먼트 길이)를 갖는다. 논리 주소가 (세그먼트 번호, 오프셋)으로 구성되며, 오프셋이 limit을 넘으면 잘못된 접근으로 처리된다는 점이 페이징과의 구조적 차이다.
4.2 가상 메모리 세그먼테이션
페이징과 마찬가지로, 필요하지 않은 세그먼트는 굳이 미리 로드하지 않는다.
- 필요한 시점에 자동으로 세그먼트를 불러옴
- 내부 단편화 없음
- 복잡한 메모리 관리로 인한 오버헤드는 여전히 존재
5. 페이징 vs 세그먼테이션 비교
| 구분 | 페이징 | 세그먼테이션 |
|---|---|---|
| 분할 단위 | 고정 크기 | 가변 크기 (논리적 의미 단위) |
| 내부 단편화 | 소량 발생 가능 | 없음 |
| 외부 단편화 | 없음 | 발생 가능 |
| 주소 구성 | (페이지 번호, 오프셋) | (세그먼트 번호, 오프셋) |
| 보호/공유 | 페이지 단위라 의미 단위 보호가 어려움 | 의미 단위라 보호·공유 설정이 직관적 |
실무에서는 둘 중 하나만 쓰기보다, 두 방식을 결합한 Paged Segmentation(세그먼트를 다시 페이지로 나누는 방식)을 쓰는 경우도 많다. 세그먼트의 논리적 보호 장점과 페이징의 단편화 회피 장점을 동시에 취하려는 절충안으로, 과거 x86 아키텍처의 메모리 관리 방식이 이런 혼합 모델의 대표적인 예다.
6. 페이지 교체 알고리즘 (Page Replacement Algorithm)
가상 메모리 페이징 환경에서는 메모리가 가득 찬 상태에서 새 페이지를 올려야 하는 상황이 반드시 발생한다. 이때 내보낼 페이지(victim page)를 고르는 기준이 페이지 교체 알고리즘이다.
좋은 victim의 조건은 가능하면 수정되지 않은(dirty bit이 0인) 페이지다. 수정된 페이지를 내보내면 디스크에 다시 써줘야 해서(write-back) 시간이 더 걸리기 때문이다.
알고리즘 성능을 비교할 때는 보통 페이지 참조열(Page Reference String)을 기준으로 페이지 폴트 횟수를 센다. 참조열은 CPU가 요청한 페이지 번호 중, 같은 페이지가 연달아 나오는 부분(폴트가 나지 않는 구간)을 생략하고 표시한 수열이다.
6.1 FIFO (First-In First-Out)
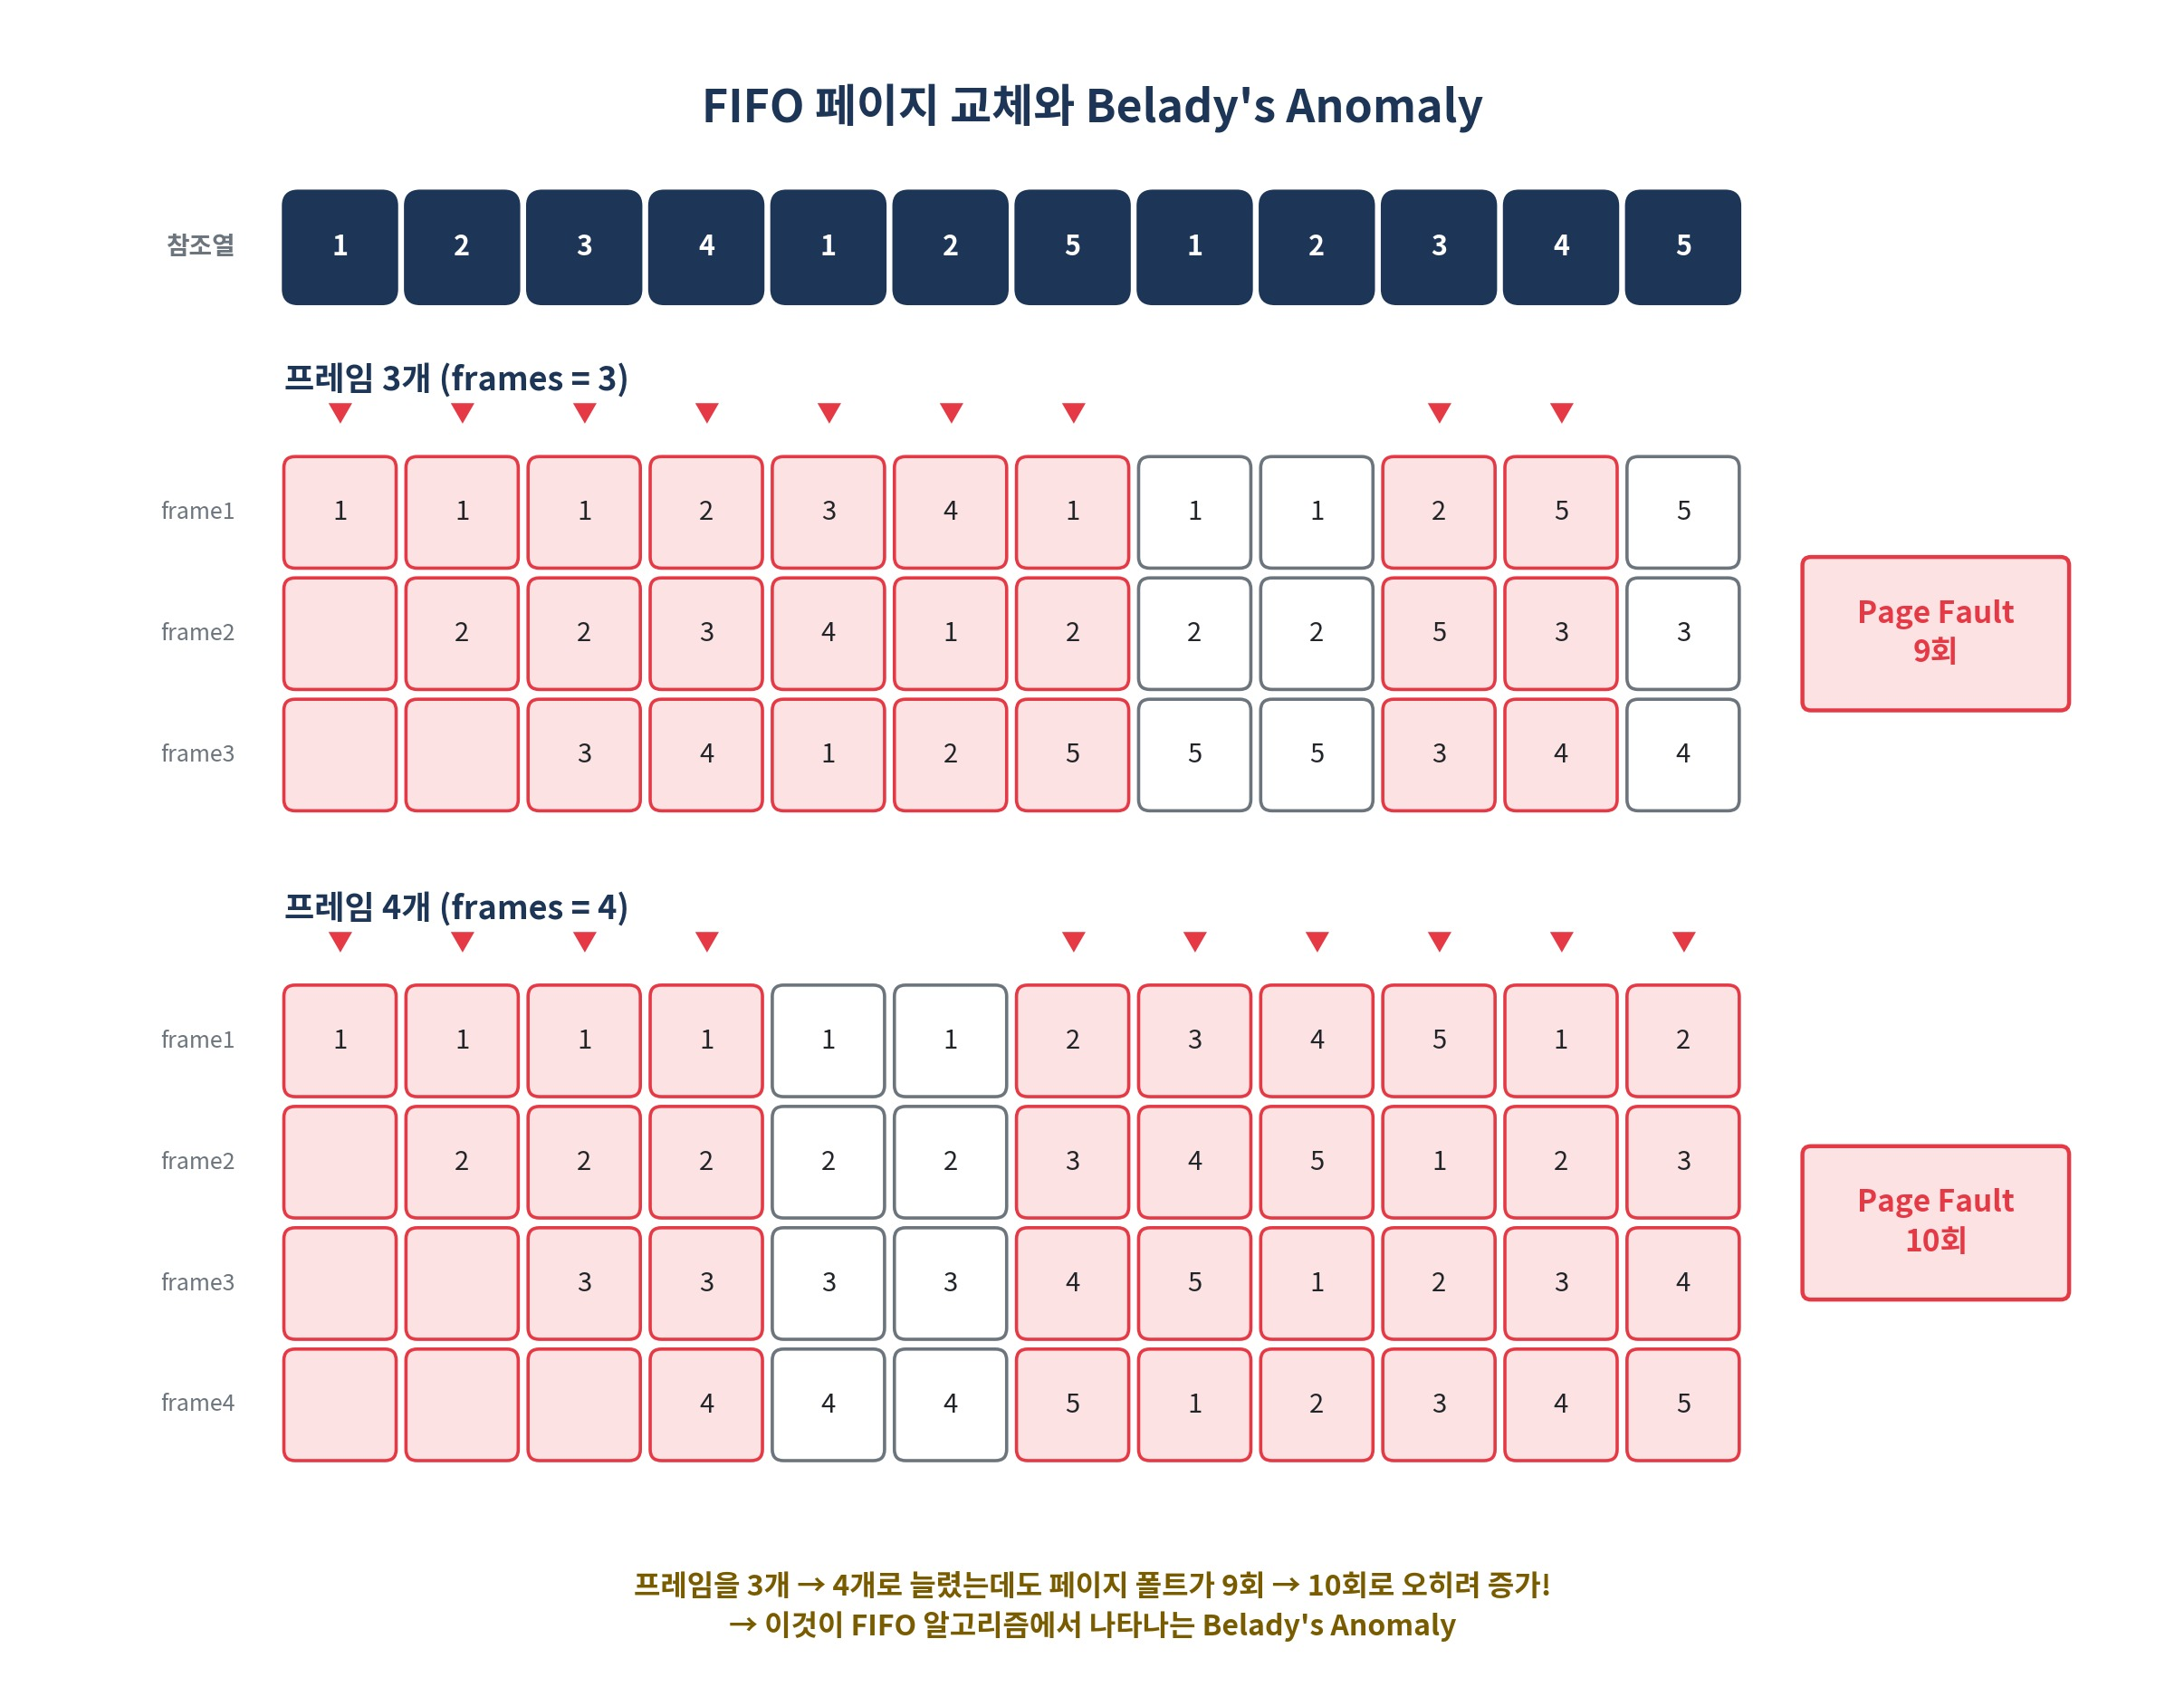
가장 먼저 메모리에 올라온 페이지를 가장 먼저 내보내는, 구현이 가장 단순한 방식이다.
- 큐(Queue) 구조로 쉽게 구현 가능
- 직관적이지만, 자주 쓰이는 페이지라도 먼저 들어왔다는 이유만으로 쫓겨날 수 있음
- Belady’s Anomaly: 프레임 수를 늘렸는데도 오히려 페이지 폴트가 더 많이 발생하는 역설적인 현상이 FIFO에서 발견된다. 이는 “프레임이 많을수록 폴트가 줄어든다”는 직관이 항상 성립하지 않음을 보여주는 대표적인 사례다.
6.2 OPT (Optimal Page Replacement)
앞으로 가장 오랫동안 사용되지 않을 페이지를 우선적으로 내보내는 알고리즘이다.
- 이론적으로 페이지 폴트 횟수가 가장 적은, 다른 알고리즘의 성능을 평가하는 기준점(upper bound) 역할
- 문제는 미래에 어떤 페이지가 참조될지 미리 알아야 하므로, 실제 운영체제에 그대로 구현할 수 없음
- 그래서 OPT는 실제 사용 알고리즘이 아니라, “이 알고리즘이 얼마나 OPT에 가까운가”를 비교하는 잣대로 쓰인다.
6.3 LRU (Least Recently Used)
가장 최근에 사용되지 않은 페이지를 내보낸다. “최근 과거”를 바탕으로 “가까운 미래”를 예측하려는 접근으로, OPT를 실제로 구현 가능하게 근사한 알고리즘이다.
구현 방식은 크게 두 가지가 있다.
- 카운터(시간 스탬프) 방식: 페이지를 참조할 때마다 타임스탬프를 갱신하고, 교체 시 가장 오래된 타임스탬프를 가진 페이지를 선택
- 스택 방식: 참조된 페이지를 스택 top으로 옮기고, 교체 시 스택 bottom의 페이지를 선택
FIFO보다 일반적으로 성능이 좋지만, 매 참조마다 갱신 작업이 필요해 하드웨어/소프트웨어 오버헤드가 크다는 단점이 있다.
6.4 LFU (Least Frequently Used)
참조 횟수(빈도)가 가장 적은 페이지를 내보내는 방식이다. LRU가 “최근성”을 본다면 LFU는 “누적 사용 빈도”를 본다.
- 한때 자주 쓰였지만 최근엔 안 쓰이는 페이지가, 참조 카운트가 높다는 이유로 계속 메모리에 남아있는 단점이 있을 수 있다.
6.5 Clock 알고리즘 (Second-Chance)
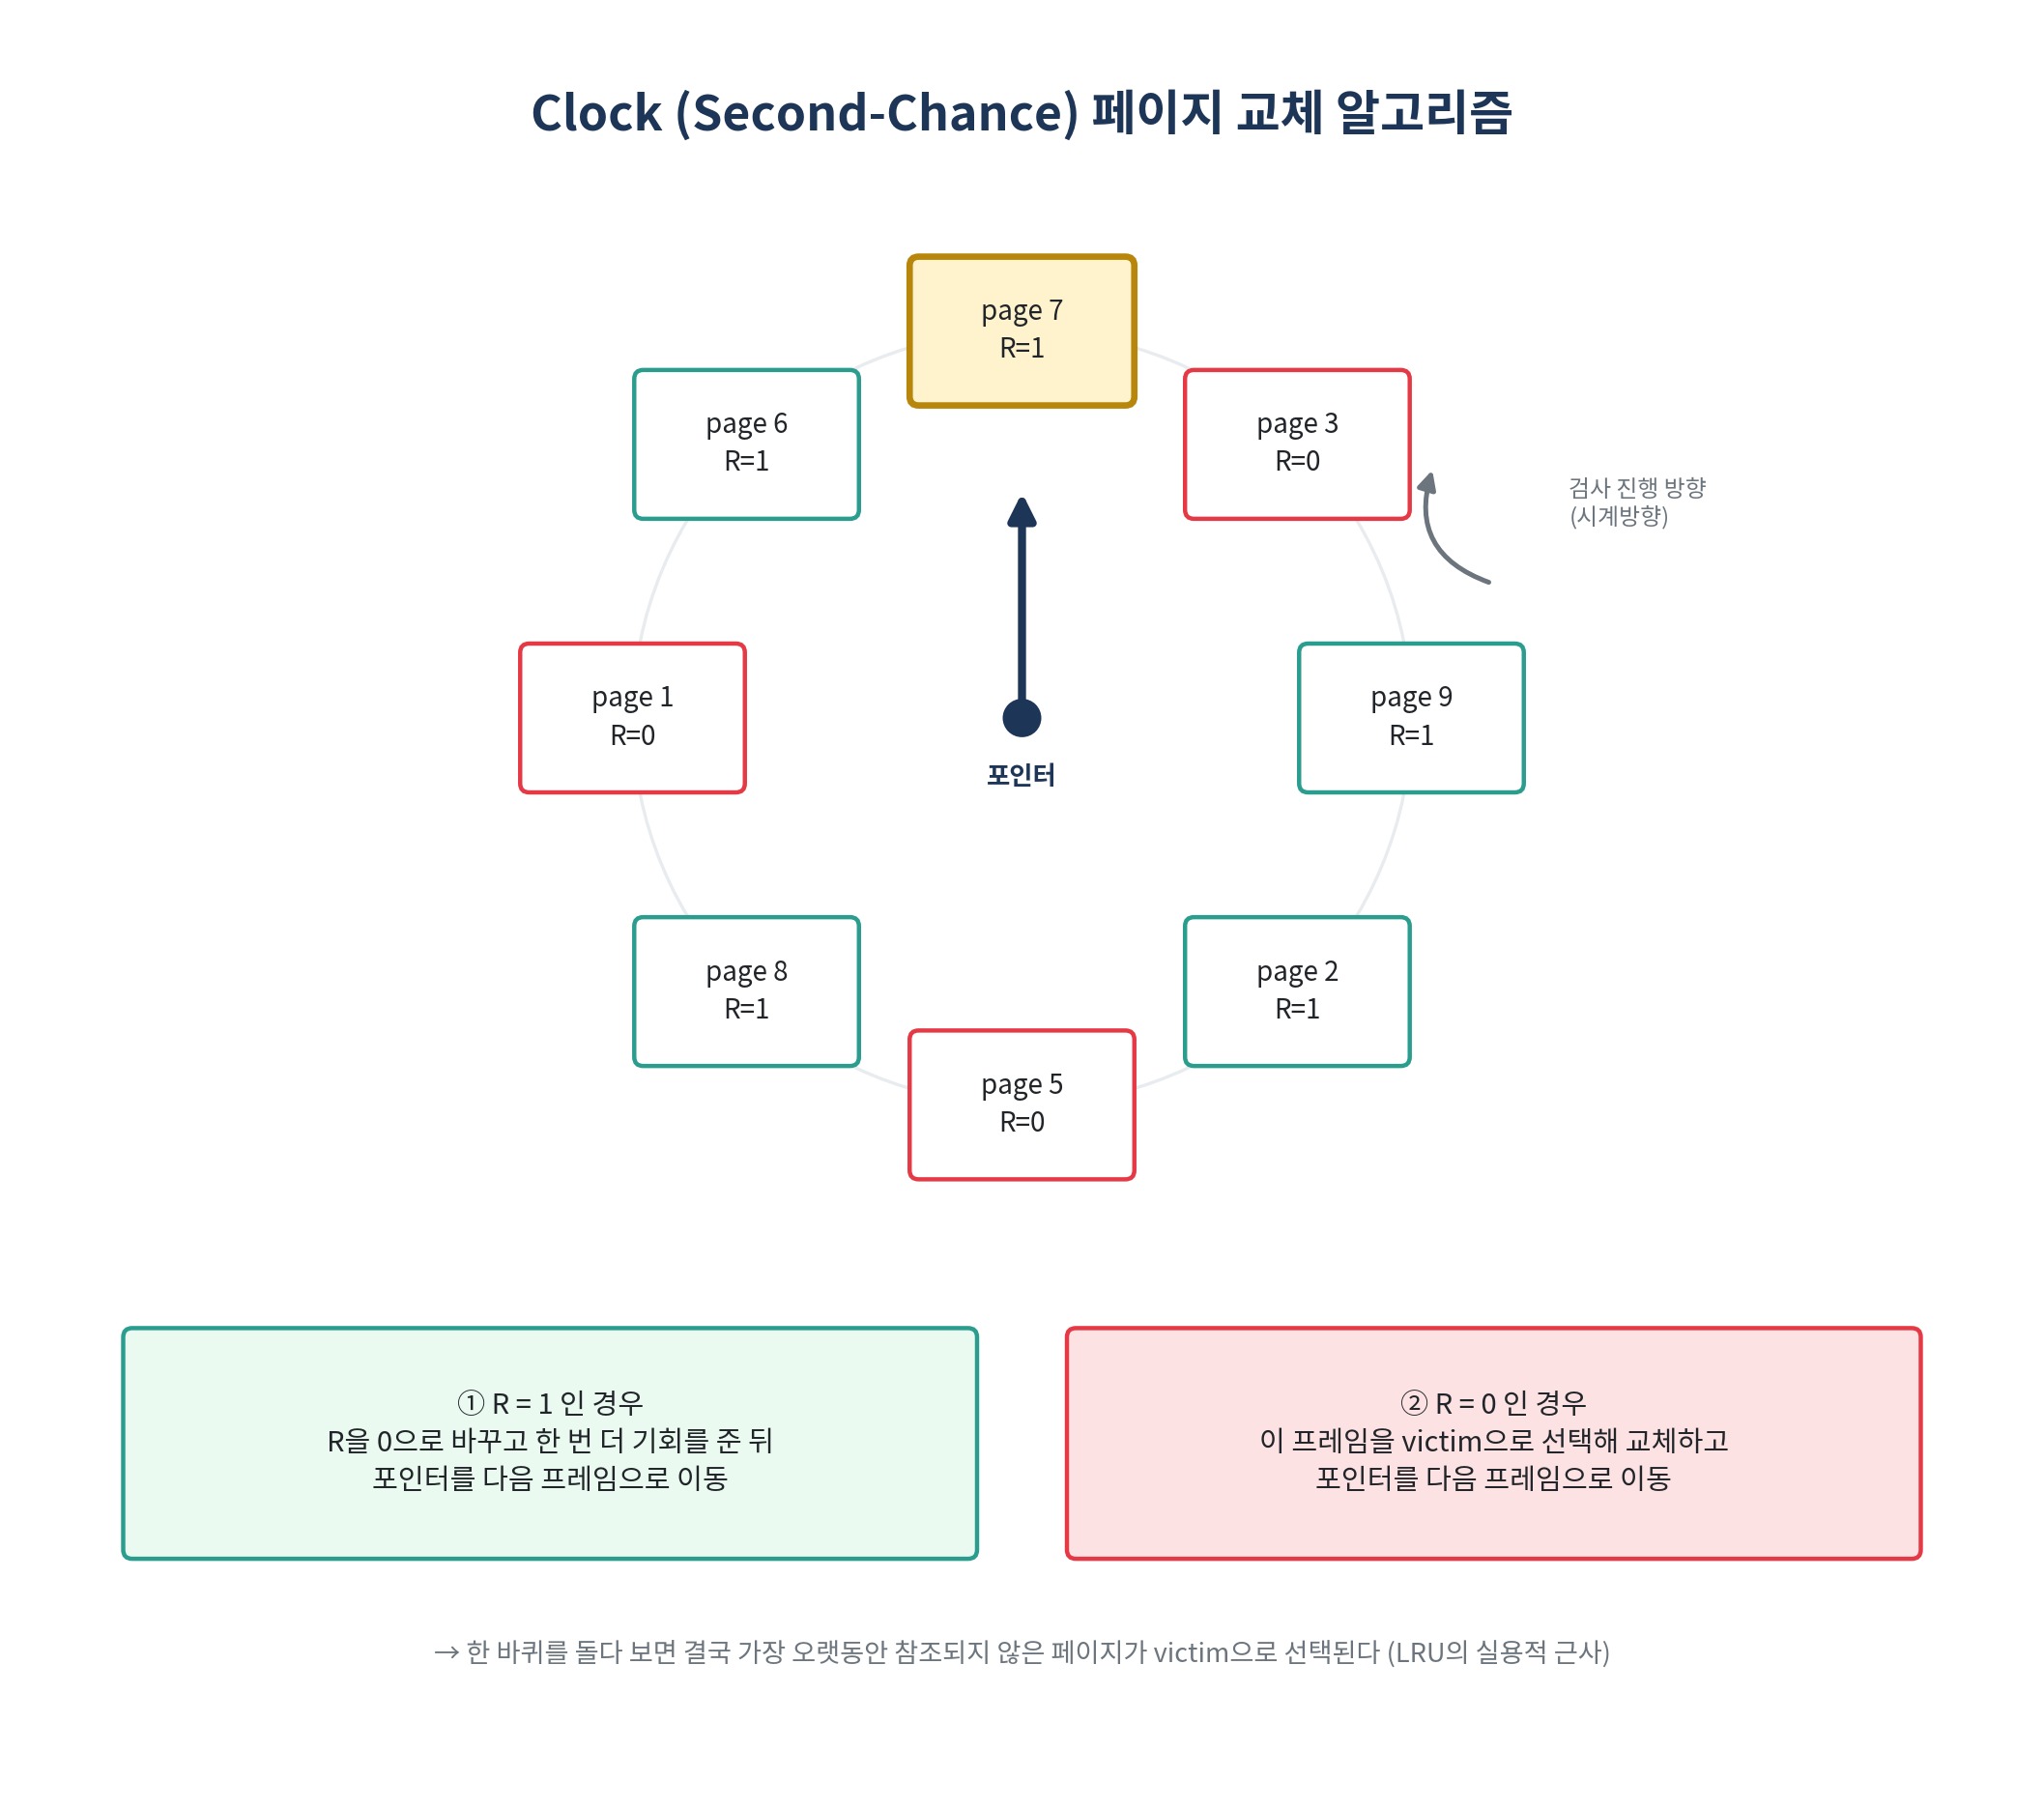
LRU를 근사하면서도 오버헤드를 줄이기 위한 실용적인 알고리즘이다.
- 각 프레임에 참조 비트(Reference bit) 하나를 둔다.
- 페이지가 참조되면 참조 비트를 1로 설정한다.
- 교체가 필요할 때, 시계처럼 순환하는 포인터가 프레임을 가리키며 검사한다.
- 참조 비트가 1이면 → 0으로 내리고(한 번 더 기회를 줌) 다음 프레임으로 이동
- 참조 비트가 0이면 → 그 페이지를 victim으로 선택
- LRU와 비슷한 효과를 내면서도 매 참조마다 갱신이 필요 없어 실제 OS에서 널리 쓰인다.
6.6 Thrashing과 Working Set (참고)
교체 알고리즘과 함께 자주 언급되는 개념으로 Thrashing이 있다. 프로세스에 할당된 프레임이 너무 적어서, 페이지 폴트와 교체가 끊임없이 반복되며 실제 작업보다 페이징 처리에 더 많은 시간을 쓰는 상태를 말한다.
이를 막기 위한 개념이 Working Set이다. 특정 시간 구간(window) 동안 프로세스가 실제로 참조한 페이지 집합을 working set으로 정의하고, 이 집합 전체를 메모리에 유지할 수 있을 때만 프로세스를 실행하도록 해서 thrashing을 억제한다.
7. 정리
| 알고리즘 | 선택 기준 | 특징 |
|---|---|---|
| FIFO | 가장 먼저 들어온 페이지 | 구현 쉬움, Belady’s Anomaly 발생 가능 |
| OPT | 미래에 가장 늦게 쓰일 페이지 | 이론적 최적, 실제 구현 불가 |
| LRU | 가장 최근에 안 쓰인 페이지 | OPT의 실용적 근사, 오버헤드 존재 |
| LFU | 참조 횟수가 가장 적은 페이지 | 빈도 기반, 최신성 반영 부족 |
| Clock | 참조 비트 기반 순환 검사 | LRU 근사 + 낮은 오버헤드, 실제 OS에서 흔히 사용 |
페이징과 세그먼테이션은 결국 “메모리를 어떤 단위로 쪼갤 것인가”에 대한 답이고, 페이지 교체 알고리즘은 그렇게 쪼갠 메모리가 가득 찼을 때 “무엇을 내보낼 것인가”에 대한 답이다. 두 주제를 묶어서 보면, 가상 메모리가 어떻게 한정된 물리 메모리로 더 큰 논리 주소 공간을 흉내 내는지 한 흐름으로 이해할 수 있다.